MakeACopy
MakeACopy est une application open source de numérisation de documents pour Android qui vous permet de numériser des documents papier avec OCR. L’application est conçue dans le respect de la vie privée : elle fonctionne entièrement hors ligne, sans cloud ni suivi.

Fonctionnalités
- Numérisation avec l’appareil photo : capturez des documents avec la caméra de l’appareil
- Détection des bords : un modèle entraîné sur mesure (DocQuadNet) repère la page sur la photo et cale le contour sur les bords du papier sans les confondre avec une ligne de cadre imprimée. Si l’option Aperçu de la détection des coins est activée (toujours en mode accessibilité), il entoure aussi la page en direct dans la caméra, mais seulement lorsqu’il en est sûr
- Correction de perspective : ajustez et recadrez les documents manuellement ou automatiquement
- Amélioration d’image : appliquez des filtres (niveaux de gris, contraste, netteté)
- OCR : reconnaissance de texte hors ligne avec PaddleOCR qui suit les lignes même sur une page légèrement inclinée
- OCR Review : révision et correction interactives des résultats OCR avec édition au niveau des mots, suggestions basées sur le dictionnaire, mise en évidence de la confiance et re-OCR pour les mots individuels
- Export PDF : enregistrement en PDF interrogeable avec texte reconnu
- Export JPEG : exportez en images JPEG de haute qualité (qualité, couleur/NB configurables)
- Numérisation multipage : combinez plusieurs pages en un seul document ; réorganisez et gérez les pages avant l’export
- Derniers scans : accédez rapidement à vos numérisations récentes
- Mode Inbox : configurez un dossier d'export par défaut (via SAF) pour une numérisation sans friction — les documents sont enregistrés automatiquement sans sélecteur de fichiers, idéal pour les workflows paperless-ngx, Nextcloud ou Syncthing
- Partager & Enregistrer : enregistrement local ou partage avec d’autres applications
- Mode sombre : thème Material 3 avec support jour/nuit
- Respect de la vie privée : 100% hors ligne, aucune connexion Internet requise
Langues OCR
MakeACopy prend en charge l’OCR hors ligne via PaddleOCR. Vous pouvez sélectionner la langue ou le groupe d’écriture lors de l’étape OCR.
- Anglais (Anglais)
- Allemand (Latin)
- Français (Latin)
- Italien (Latin)
- Espagnol (Latin)
- Portugais (Latin)
- Néerlandais (Latin)
- Polonais (Latin)
- Tchèque (Latin)
- Slovaque (Latin)
- Hongrois (Latin)
- Roumain (Latin)
- Danois (Latin)
- Norvégien (Latin)
- Suédois (Latin)
- Turc (Latin)
- Chinois (simplifié) (Chinois)
- Chinois (traditionnel) (Chinois)
- Russe (Slave oriental)
- Thaï (Thaï)
- Arabe (Arabe)
- Persan/Farsi (Arabe)
- Hindi (Devanagari)
- Grec (Grec)
Remarque : Le texte recherchable d’un PDF exporté est une couche invisible posée sur l’image de la page. Elle utilise une police minuscule sans glyphes visibles, intégrée à l’application, comme le font Tesseract et OCRmyPDF : le texte de toute écriture, y compris le chinois, le japonais, l’arabe, le persan et l’hindi, peut ainsi être recherché et copié sans embarquer de polices.
Éditions et OCR
MakeACopy reconnaît le texte avec PaddleOCR. L’édition Full sur F-Droid, Google Play et GitHub Releases apporte tous les groupes de langues ; l’édition Light sur GitHub Releases n’apporte que l’écriture latine et fait environ la moitié de la taille.
Choisissez dans le fragment OCR l’écriture ou le groupe de langues le plus adapté. Pour les documents en allemand, choisissez par exemple Latin.
| Langue du document | Choix dans le fragment OCR |
|---|---|
| Anglais | Anglais |
| Allemand, français, italien, espagnol, portugais, néerlandais, polonais, tchèque, slovaque, hongrois, roumain, danois, norvégien, suédois, turc | Latin |
| Chinois simplifié ou traditionnel | Chinois |
| Russe | Slave oriental |
| Thaï | Thaï |
| Arabe et persan/farsi | Arabe |
| Hindi | Devanagari |
| Grec | Grec |
Captures d’écran
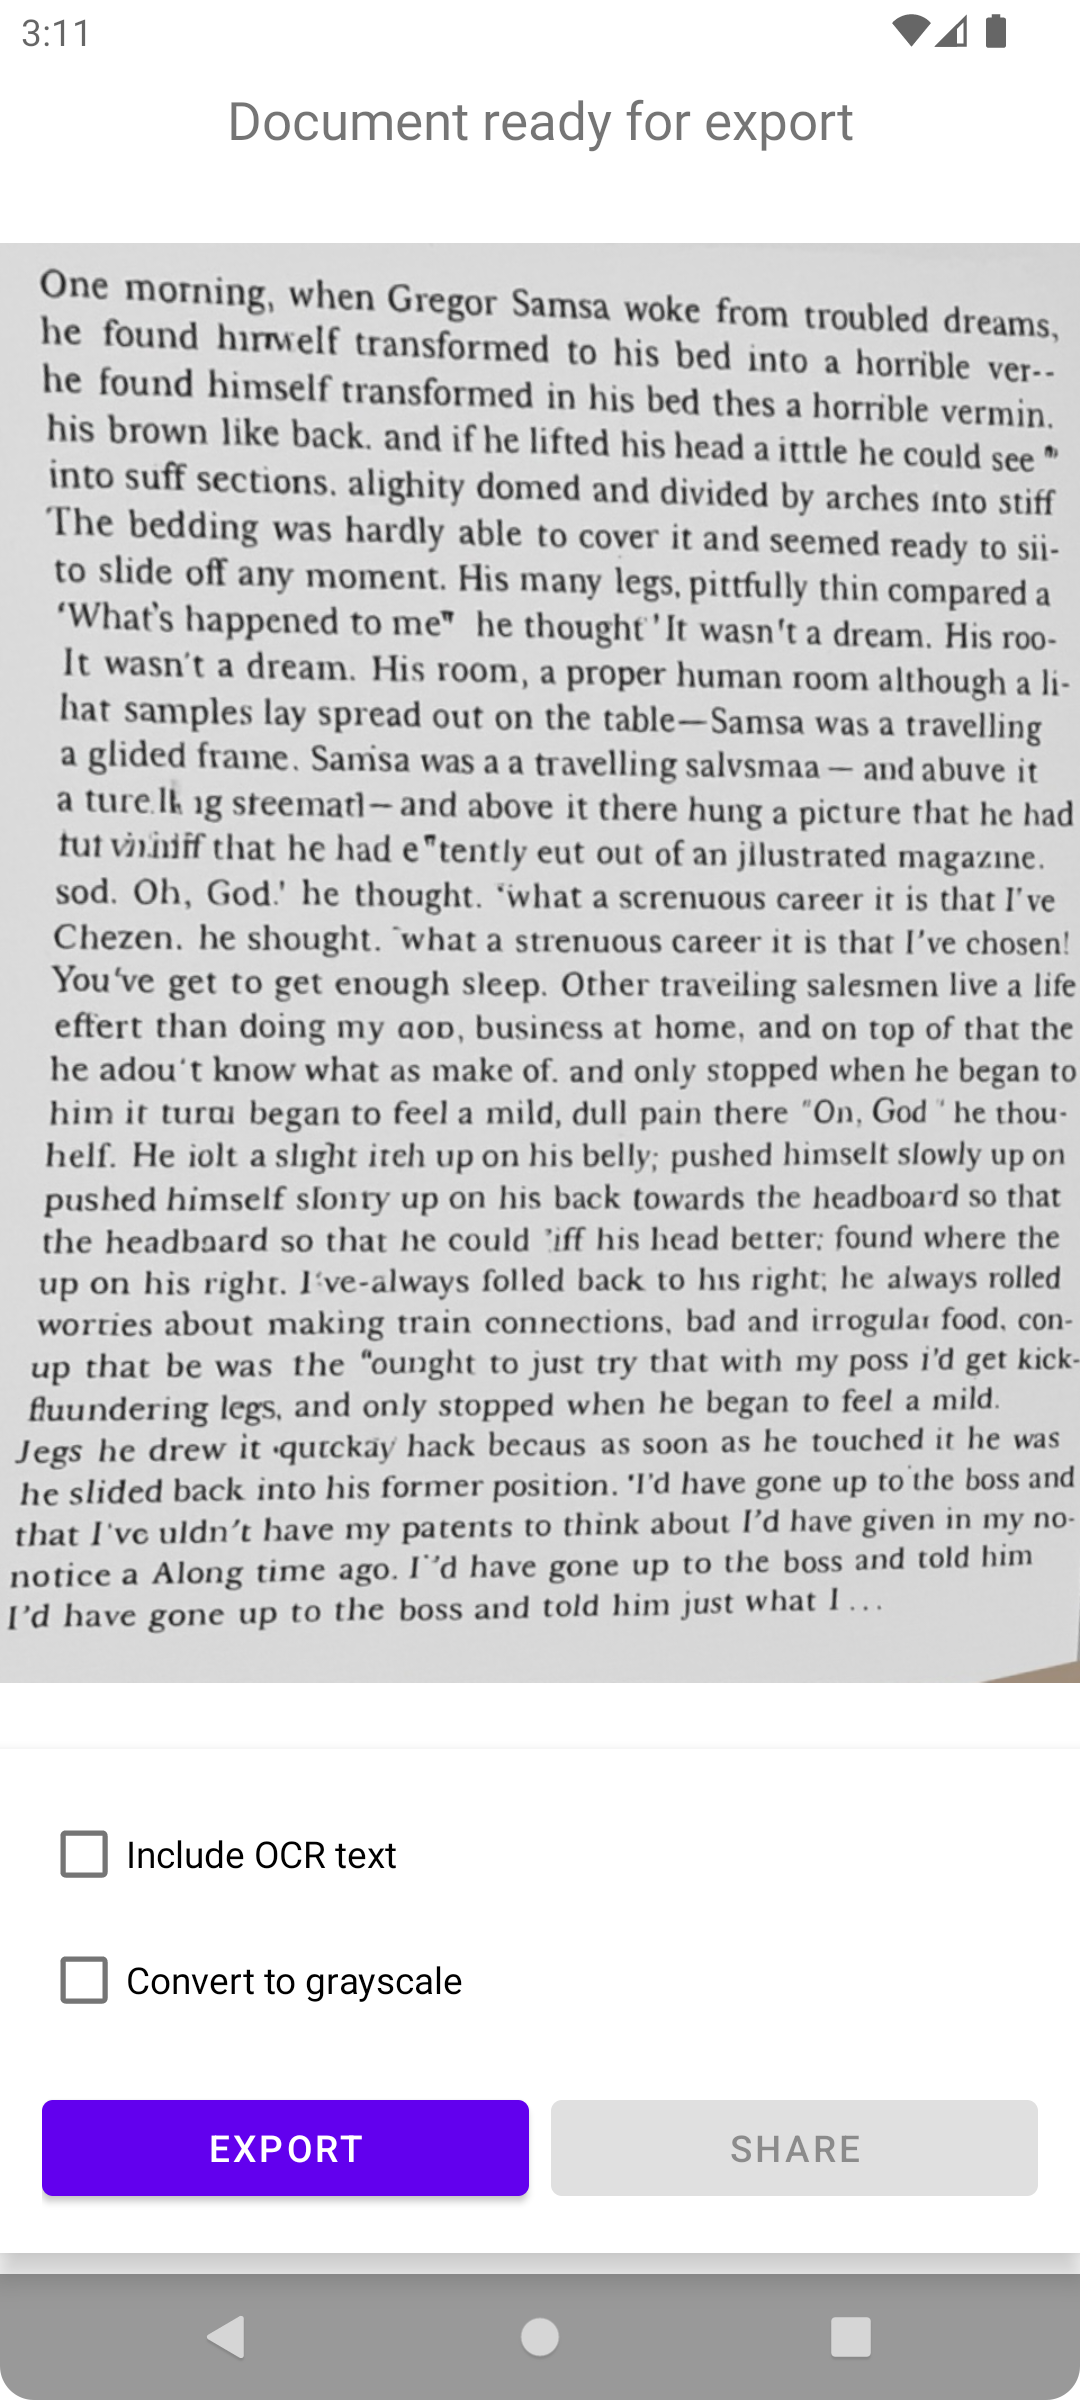
Guide d’utilisation
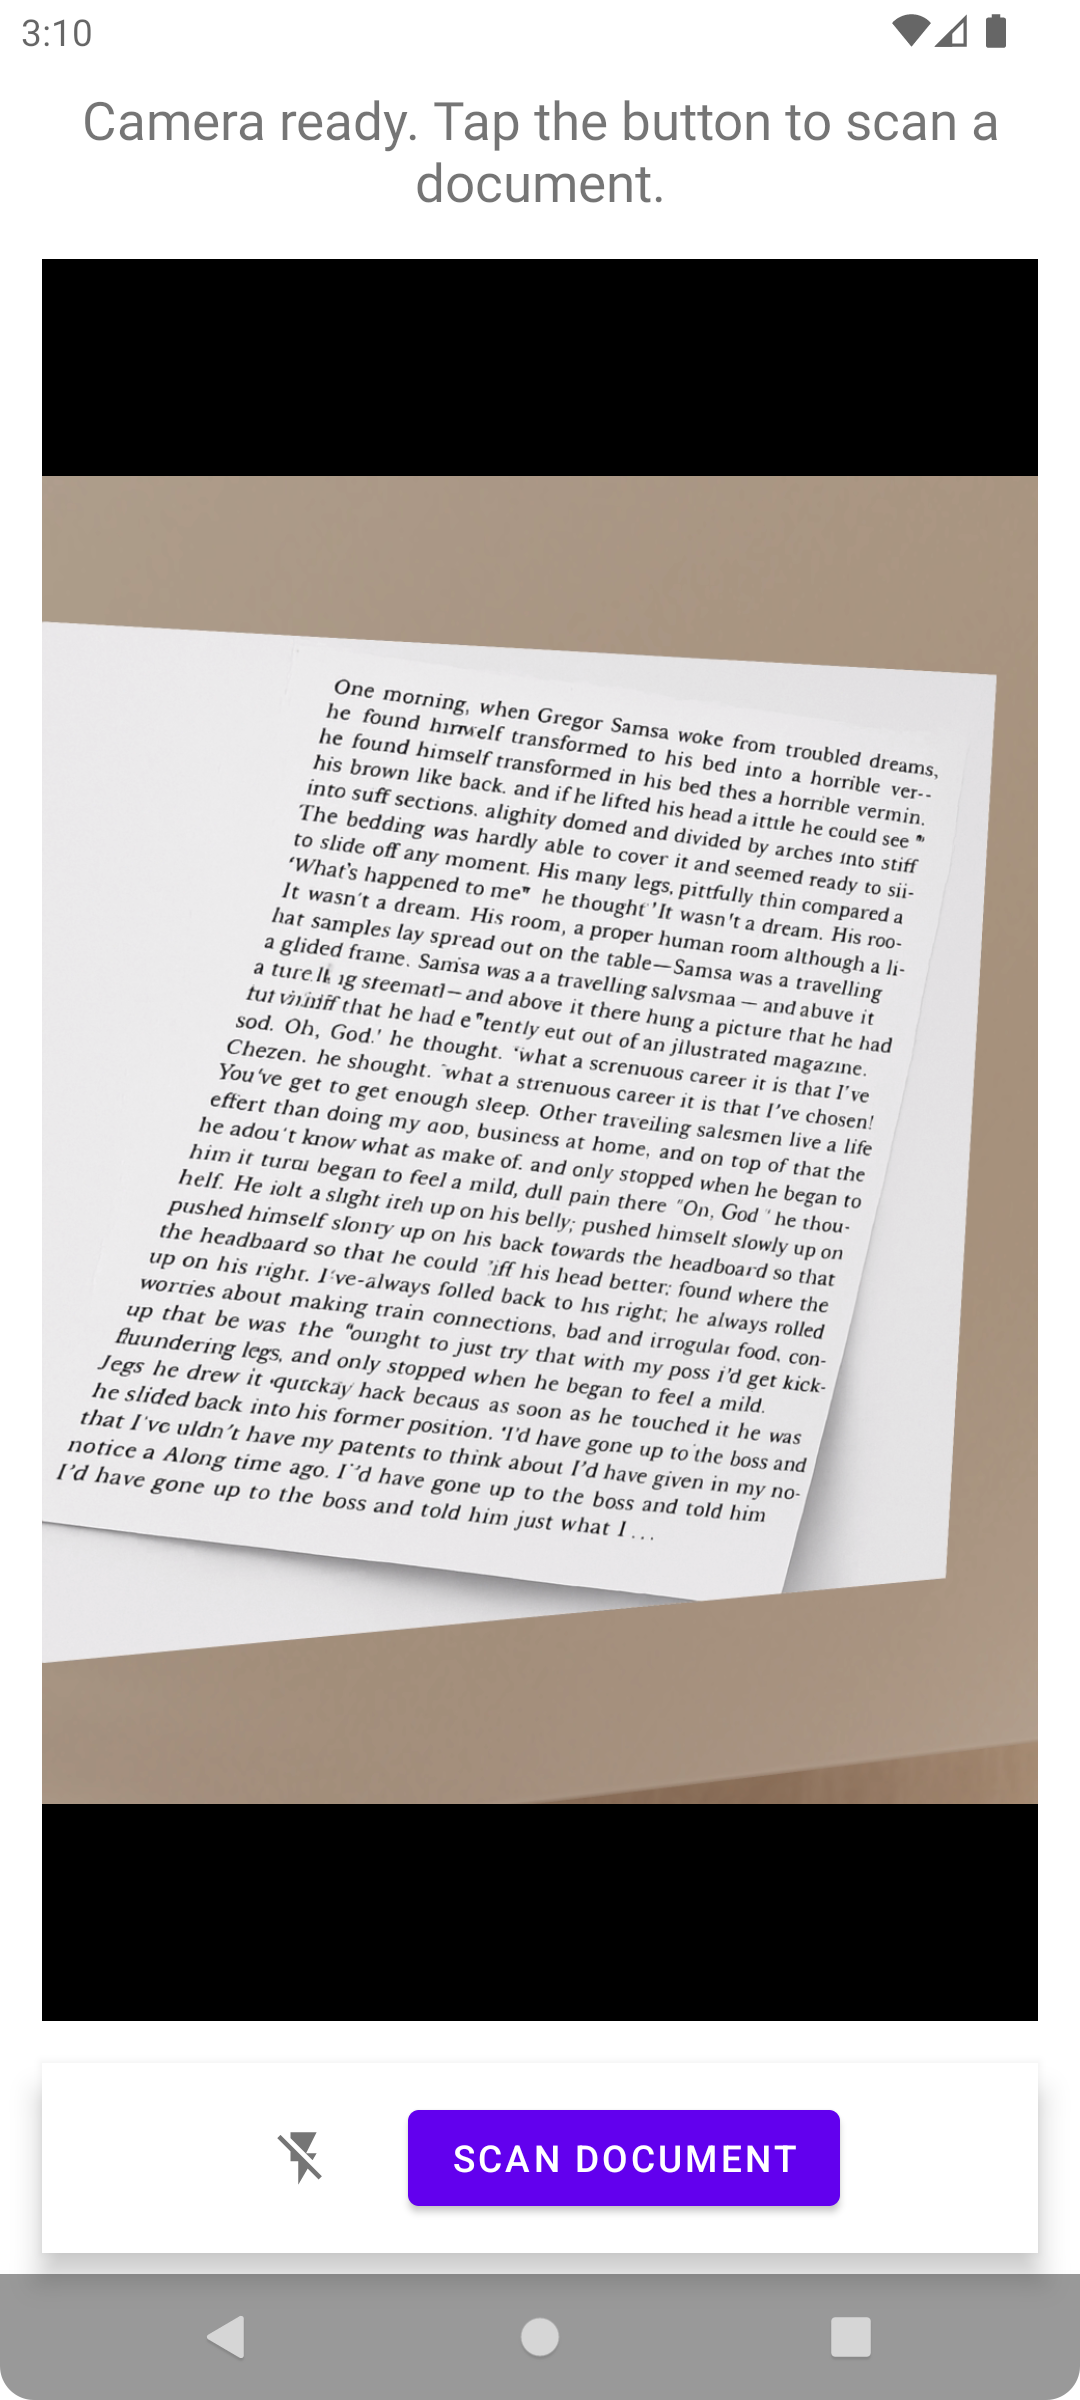
- Numériser le document : ouvrez l’application et touchez le bouton de scan pour capturer un document
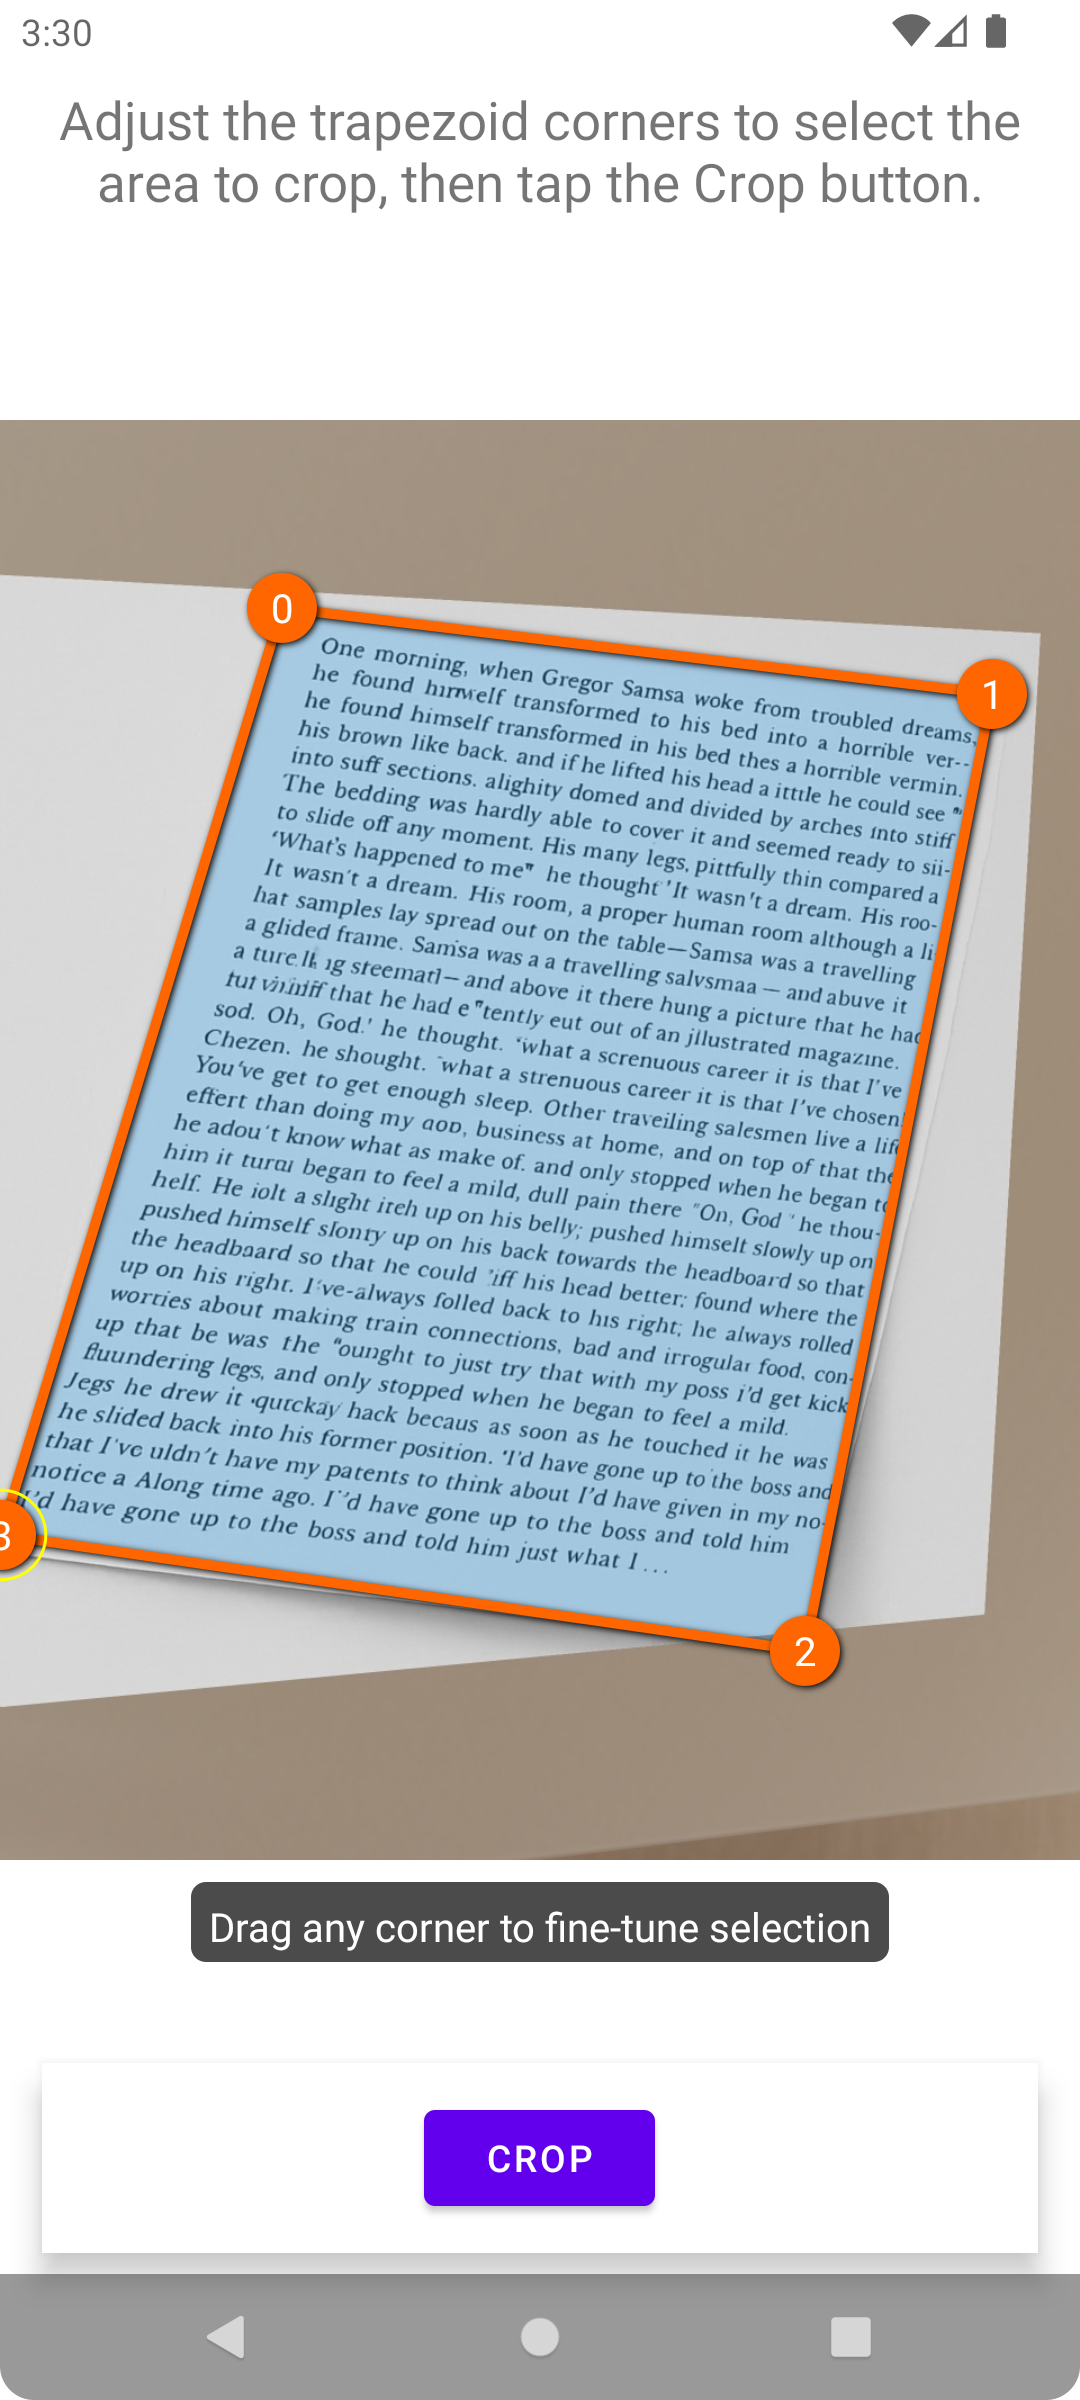
- Ajuster les coins : peaufinez les bords détectés
- Recadrer & améliorer : appliquez le recadrage et améliorez l’image si nécessaire
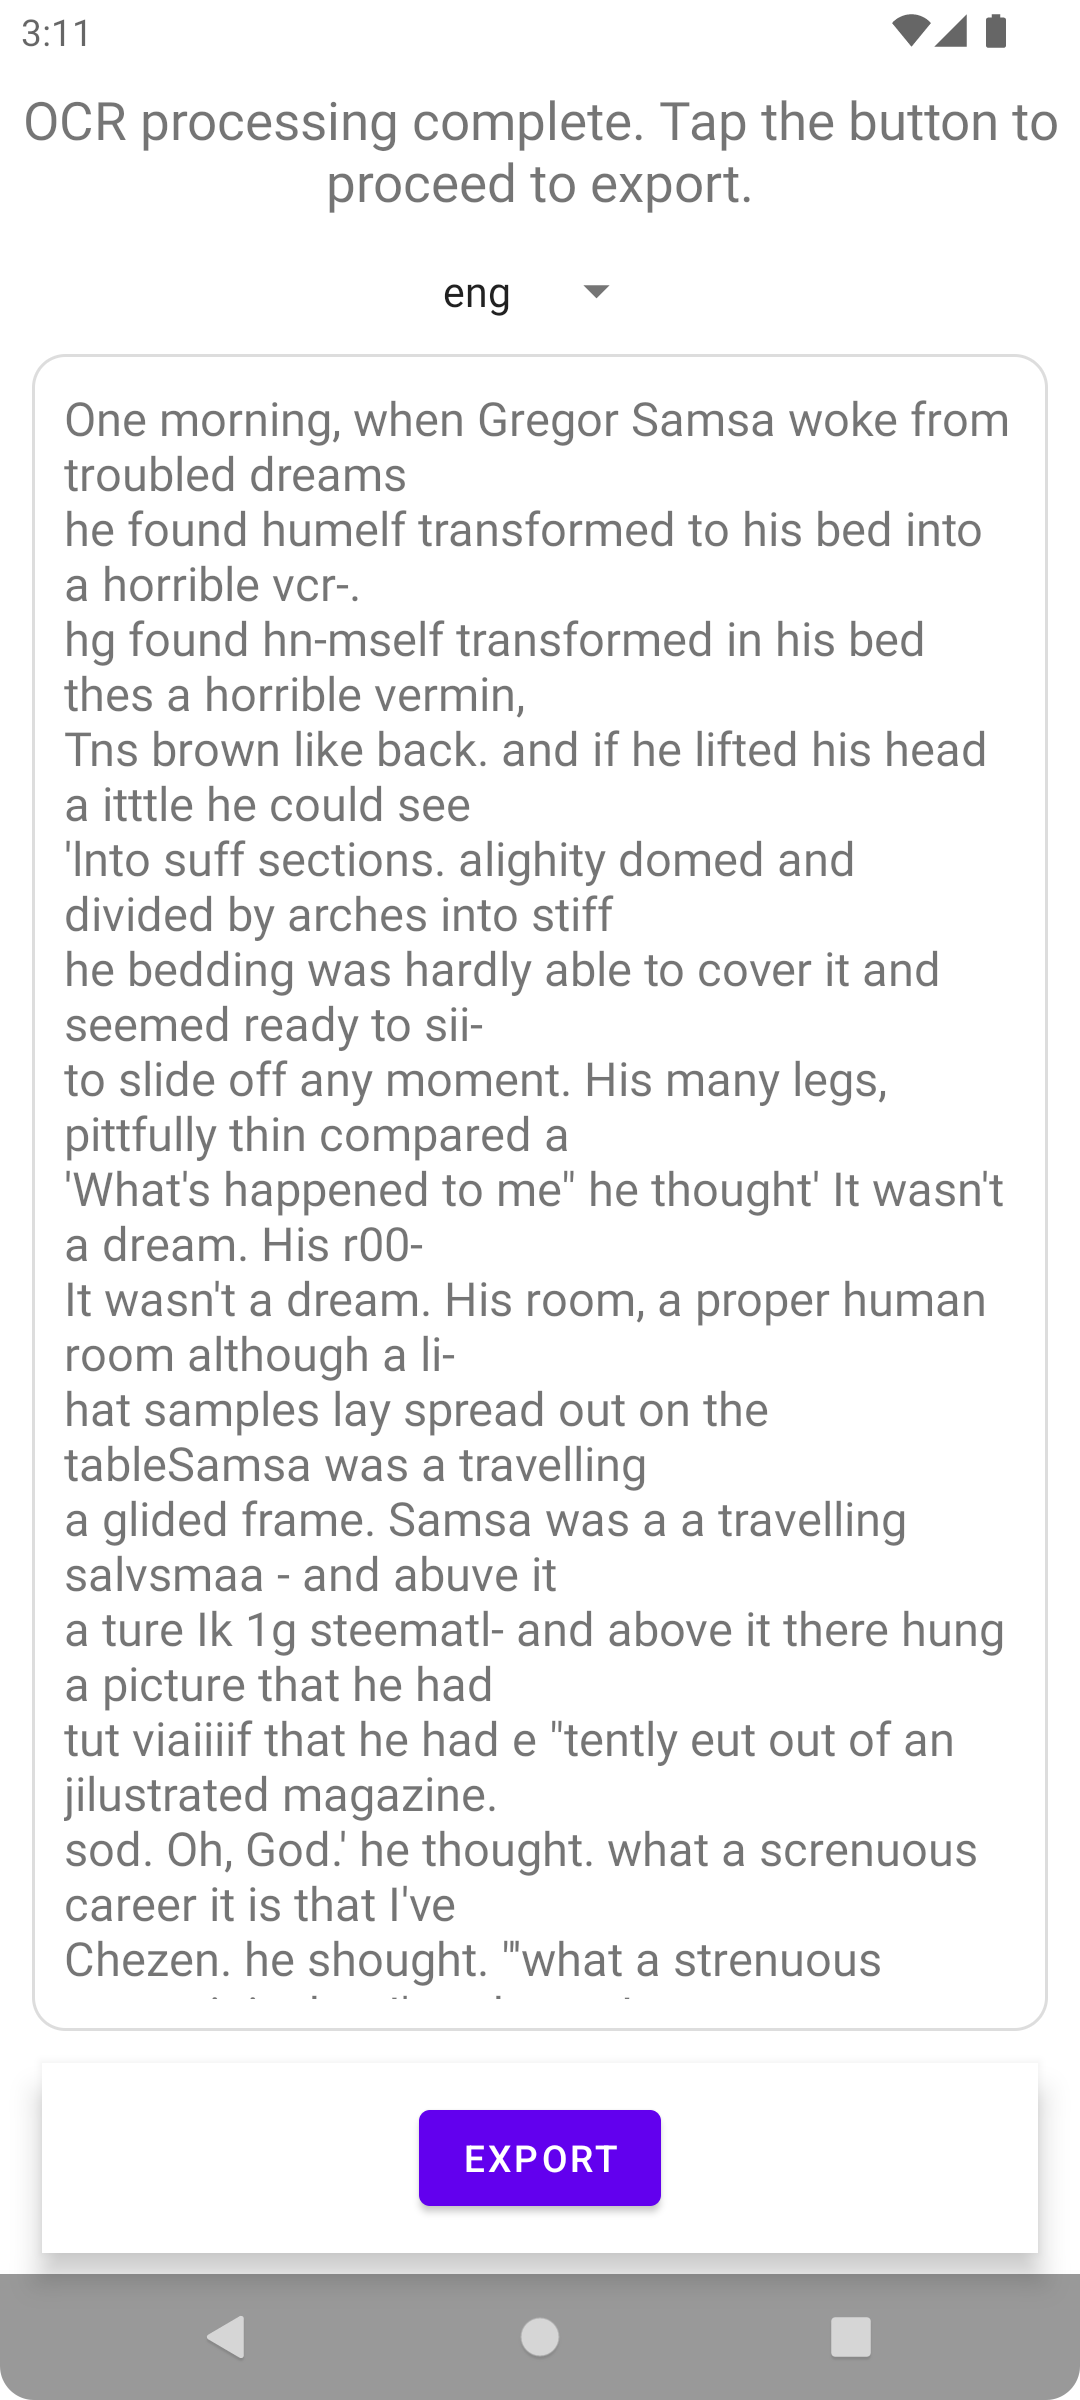
- Traitement OCR : l’application reconnaît le texte du document
- Exporter & partager : enregistrez en PDF ou partagez avec d’autres applications
Confidentialité
- Aucune connexion Internet requise
- Aucune requête serveur ni télémétrie
- Traitement OCR local sur votre appareil
- Autorisations requises : Appareil photo (et vibration pour le retour haptique) ; aucune autorisation de stockage, les fichiers sont choisis via les boîtes de dialogue du système
- Aucune connexion à des tiers
Pour plus de détails, consultez notre politique de confidentialité (en anglais).
Installation
F-Droid
MakeACopy est disponible sur F-Droid : f-droid.org/packages/de.schliweb.makeacopy.
Pour la conformité F-Droid, le seul composant natif, ONNX Runtime (fournisseur d’exécution CPU, liaisons Java), est
construit à partir des sources de external/onnxruntime. Les bibliothèques résultantes sont intégrées à l’application pendant la construction ; aucun binaire précompilé
n’est stocké dans le dépôt.
GitHub Releases
Vous pouvez télécharger la dernière APK sur la page Releases.
Vérification de l’APK
Pour vérifier l’authenticité des versions de MakeACopy, comparez l’empreinte du certificat de signature
ci‑dessous avec la sortie de apksigner ou AppVerifier.
SHA-256
- Clé d’upload (GitHub / F-Droid / APKs en sideload)
AE:32:2D:3F:B7:1A:FE:21:DF:47:27:E3:7A:5C:68:03:51:1D:5A:2F:E1:FC:31:35:43:0C:EE:06:99:FA:1B:34 - Clé de signature Google Play (versions Play Store)
C0:71:44:39:CB:51:62:32:A4:47:91:7A:6F:C2:28:1E:45:FA:AA:DD:37:F8:30:B1:01:1F:B4:85:68:8E:0D:64
Commandes de vérification
# Avec apksigner (depuis Android SDK build-tools)
apksigner verify --print-certs MakeACopy-vX.Y.Z.apk

# Avec AppVerifier (https://github.com/soupslurpr/AppVerifier)
appverifier verify MakeACopy-vX.Y.Z.apk
❤️ Soutenir ce projet
MakeACopy est gratuit et open source. Si l’application vous est utile, pensez à soutenir le développement :

FAQ
Numérisation (Caméra)
- L’image est floue / le texte est difficile à lire
- Assurez un éclairage suffisant ; évitez une lumière d’ambiance faible et chaude.
- Tenez l’appareil bien stable ou appuyez‑le.
- Déclenchez l’autofocus en touchant la zone pertinente dans le viseur (si disponible).
- Éloignez légèrement l’appareil puis recadrez — être trop proche peut nuire à la mise au point. - Fortes ombres ou reflets
- Éclairez le document uniformément depuis plusieurs côtés.
- Évitez les sources directes provoquant des reflets (p. ex. sur papier brillant).
- Posez le document sur un fond mat et contrasté. - L’image est trop sombre/clair
- Améliorez l’éclairage.
- N’utilisez le flash qu’en cas de besoin — il peut créer des reflets. - Perspective déformée
- Prenez la photo le plus perpendiculairement possible à la surface du document. - Que signifie le score d’encadrement/qualité ?
Le Mode Accessibilité peut annoncer un pourcentage (0–100 %) pendant l’alignement. Cette valeur est un indicateur de confiance pour la détection des coins : elle dépend (a) de la surface du quadrilatère détecté dans l’image, (b) du caractère « rectangulaire » des coins (angles proches de 90°) et (c) de la symétrie des longueurs des côtés opposés.
Important : la stabilité sur plusieurs images est utilisée séparément pour garder les annonces discrètes ; elle ne fait pas partie de ce pourcentage. - Comment améliorer le score ?
- Éclairage homogène et suffisant ; évitez l’éblouissement/les ombres dures.
- Tenez le téléphone parallèle à la page ; évitez de le pencher. Gardez une petite marge avec les quatre coins visibles.
- Si vous êtes trop près, reculez légèrement et recadrez ensuite.
- Placez le papier sur un fond mat et contrasté.
- Restez brièvement immobile pour stabiliser la détection.
- Adaptez l’orientation : A4/Letter → souvent portrait ; éléments très larges (tickets/cartes) → essayez paysage. - Dois‑je tenir le téléphone en portrait ou en paysage ?
A4/Letter : le portrait convient généralement. Éléments très larges (tickets, cartes) : essayez paysage. Les indications s’adaptent à la façon dont vous tenez le téléphone. - Que signifient « gauche/droite/haut/bas » en mode
paysage ?
Remarque sur la tenue du téléphone (paysage) : l’écran caméra reste en orientation portrait. Les indications directionnelles (« gauche/droite/haut/bas ») se réfèrent à l’aperçu aligné « à l’endroit ».
Si vous tenez le téléphone de côté, selon l’appareil/la version d’Android, - les indications peuvent rester celles du mode portrait (car l’interface ne passe pas en paysage), ou - les axes d’analyse internes peuvent suivre la rotation de l’affichage.
Si « gauche/droite/haut/bas » semble illogique, revenez en portrait ou faites pivoter le téléphone de 180° et voyez si les indications deviennent plus cohérentes. - J’entends constamment « Éloignez‑vous/Move back »
L’application supprime les invites de distance sans document clair et limite les répétitions. Améliorez l’éclairage (utilisez la lampe si besoin), incluez toute la page avec une petite marge, et restez brièvement immobile. - L’application suggère‑t‑elle portrait ou paysage ?
Oui. En Mode Accessibilité, l’application peut suggérer si le portrait ou le paysage semble mieux convenir à la page actuelle.
Le conseil n’est donné que si - l’estimation est suffisamment fiable (confiance ≥ 0,30), et - aucun document plausible n’est actuellement détecté (pour ne pas masquer les indications normales).
Pour rester discret, ce conseil passe par la même logique de guidage que les autres annonces (stabilité brève sur plusieurs images) et il est limité en fréquence.
Détection des bords
- Les bords du document sont mal détectés
- Assurez un bon contraste entre le document et le fond (par ex. papier clair sur table sombre).
- Aplatissez le papier (sans vagues/pliures) et alignez‑le correctement.
- Évitez les ombres pouvant être interprétées comme des bords. - Aucune détection automatique
- Avec l’option Aperçu de la détection des coins activée, la caméra n’affiche aucun contour tant que le modèle n’est pas sûr de la page, par exemple dans l’obscurité ou lorsque l’objectif est masqué.
- Reprenez la photo avec un meilleur éclairage.
- Utilisez l’ajustement manuel des coins après le scan pour déplacer les points. - Résultat incliné ou rogné
- Après la détection automatique, vérifiez les quatre points et ajustez‑les manuellement si nécessaire.
OCR (Reconnaissance de texte)
- L’OCR ne reconnaît presque aucun texte
- Vérifiez que la langue correcte est sélectionnée.
- Numérisez en bonne qualité : image nette, lumière suffisante, peu de bruit.
- Évitez les caractères trop petits — remplissez davantage la page ou rapprochez‑vous (sans flou). - Mauvaise langue / les accents ne sont pas reconnus
- Choisissez la langue OCR appropriée dans l’application. - Langues mélangées dans le document
- Si possible, numérisez les sections séparément par langue.
- Sinon, choisissez la langue principale ; le texte mixte peut réduire la précision. - L’écriture manuscrite n’est pas reconnue
- Tesseract est principalement prévu pour le texte imprimé ; la reconnaissance manuscrite est limitée.
- De meilleurs résultats avec une écriture claire et proche de l’imprimé ; sinon, envisagez une transcription manuelle. - Mauvaise rotation/orientation de l’OCR
- L’application détecte automatiquement l’orientation : elle essaie l’OCR en interne par pas de 90° (0°, 90°, 180°, 270°) et retient le meilleur résultat. Si la page est déjà bien orientée, elle s’arrête plus tôt pour gagner du temps.
- Si la page est très inclinée, faites-la pivoter avant l’OCR à l’aide des boutons de rotation par pas de 90°, jusqu’à ce que les lignes de texte soient horizontales.
- Évitez une forte perspective ; alignez le document aussi droit que possible. - Que fait l’option « Rotation automatique OCR (appliquer aussi
à l’export) » ?
Lorsqu’elle est activée, l’application exécute l’OCR avec des rotations supplémentaires par pas de 90° (0°, 90°, 180°, 270°) et choisit le meilleur résultat (selon la confiance moyenne OCR ; en cas d’égalité, selon la longueur du texte). Si la première tentative (0°) est déjà suffisamment bonne, les rotations restantes sont ignorées pour gagner du temps.
Elle applique aussi la rotation détectée au scan courant, afin que l’image/le PDF exporté soit orienté en conséquence. Lorsqu’elle est désactivée, l’OCR n’est exécuté que dans l’orientation actuelle et rien n’est automatiquement pivoté pour l’export. - La recherche dans le PDF ne fonctionne pas
- Vérifiez si la langue sélectionnée est correcte ; une mauvaise langue produit un texte reconnu non concordant.
- Vous pouvez aussi exporter le texte OCR séparément en fichier TXT.
Révision OCR
- Qu’est-ce que la révision OCR ?
La révision OCR est un écran interactif qui te permet de vérifier et corriger le texte reconnu avant l’export. Chaque mot reconnu est affiché sous forme de cadre superposé au document, avec un code couleur indiquant le niveau de confiance (vert = confiance élevée, rouge = confiance faible). - Comment ouvrir la révision OCR ?
Une fois le traitement OCR terminé, appuie sur le bouton « Révision » (icône stylo) dans l’écran OCR. Cela ouvre l’écran de révision, où tu peux examiner et modifier les résultats. - Quels sont les différents modes d’affichage ?
L’écran de révision comporte trois onglets :
- Mise en page : affiche les cadres des mots sur un fond neutre. Appuie sur un mot pour le modifier, appui long pour plus d’options.
- Document : affiche l’image scannée originale avec les cadres des mots superposés. Utile pour comparer les résultats OCR avec le document réel.
- Texte : vue d’éditeur de texte simple permettant de modifier directement l’ensemble du texte. - Quelle est la différence entre un appui et un appui long sur un
mot ?
Appui (clic court) : ouvre la boîte de dialogue d’édition intégrée, où tu peux :
- Modifier directement le texte du mot
- Voir les suggestions basées sur le dictionnaire (si disponibles) et en sélectionner une pour l’appliquer
Appui long (maintenir) : ouvre un menu contextuel avec des options supplémentaires :
- Modifier… : identique à l’appui — ouvre la boîte de dialogue d’édition intégrée
- Fusionner avec le suivant : combine ce mot avec le mot suivant en un seul
- Diviser : coupe le mot en deux parties distinctes
- Supprimer : supprime complètement le mot
- Casse : modifier la capitalisation (MAJUSCULES, minuscules, Casse Titre)
- Langue… : définir la langue pour ce mot spécifique et relancer éventuellement l’OCR uniquement pour ce mot - Que sont les suggestions du dictionnaire ?
Lorsque tu appuies sur un mot pour le modifier, l’application affiche des suggestions issues du dictionnaire, basées sur la similarité avec le mot actuel. Cela aide à corriger les erreurs OCR courantes. Appuie sur une suggestion pour l’appliquer. Les suggestions sont classées selon la distance de Levenshtein, avec une pondération spécifique pour les confusions OCR typiques (0↔O, 1↔l, 5↔S, etc.). - Que fait « Relancer l’OCR » ?
Dans la boîte de dialogue de langue (appui long → Langue…), tu peux sélectionner une autre langue et appuyer sur « Relancer l’OCR ». Cela relance la reconnaissance de texte uniquement pour ce mot, en utilisant la langue sélectionnée. Utile lorsqu’un mot dans une autre écriture (par exemple du persan dans un document anglais) a été mal reconnu. - Comment enregistrer mes modifications ?
Appuie sur le bouton « Enregistrer » en bas de l’écran de révision. Cela applique tes corrections au résultat OCR. Si tu appuies sur « Retour » ou sur le bouton X alors que des modifications ne sont pas enregistrées, l’application te demandera si tu souhaites les ignorer. - Que signifient les cadres en couleur ?
- Contour vert/turquoise : confiance élevée — le moteur OCR est relativement sûr de ce mot
- Contour rouge : confiance faible (inférieure à 60 %) — le mot peut nécessiter une vérification manuelle
- Contour jaune : mot actuellement sélectionné
Plus de questions ? Ouvrez un ticket : github.com/egdels/makeacopy/issues.
Licence
MakeACopy est sous licence Apache License 2.0.
Copyright 2025 Christian Kierdorf

Licensed under the Apache License, Version 2.0 (the "License");
you may not use this file except in compliance with the License.
You may obtain a copy of the License at

    http://www.apache.org/licenses/LICENSE-2.0

Unless required by applicable law or agreed to in writing, software
distributed under the License is distributed on an "AS IS" BASIS,
WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
See the License for the specific language governing permissions and
limitations under the License.