MakeACopy
MakeACopy ist eine Open-Source-Dokumentenscanner-App für Android, mit der Sie Papierdokumente mit OCR-Funktionalität digitalisieren können. Die App ist datenschutzfreundlich konzipiert und arbeitet vollständig offline ohne Cloud-Anbindung oder Tracking.

Funktionen
- Kamera-Scan: Erfassen von Dokumenten mit der Gerätekamera
- Kantenerkennung: Ein selbst trainiertes Modell (DocQuadNet) findet die Seite auf dem Foto und legt den Umriss auf die Papierkanten, ohne eine gedruckte Rahmenlinie dafür zu halten. Ist in den Optionen Vorschau Eckenerkennung eingeschaltet (im Barrierefreiheitsmodus immer), umrandet es die Seite auch live in der Kamera, aber nur, wenn es sich sicher ist
- Perspektivkorrektur: Anpassen und Zuschneiden von Dokumenten mit manueller oder automatischer Perspektivkorrektur
- Bildverbesserung: Filter anwenden (Graustufen, Kontrast, Schärfen)
- OCR: Offline-Texterkennung mit PaddleOCR die Textzeilen auch bei leicht schräger Seite folgt
- OCR Review: Interaktive Überprüfung und Korrektur von OCR-Ergebnissen mit Wort-Level-Bearbeitung, wörterbuchbasierten Vorschlägen, Konfidenz-Hervorhebung und Re-OCR für einzelne Wörter
- PDF-Export: Speichern als durchsuchbares PDF mit erkanntem Text
- JPEG-Export: Export als hochwertige JPEG-Bilder (Qualität, Farbe/Schwarzweiß konfigurierbar)
- Mehrseitige Scans: Mehrere Seiten zu einem Dokument zusammenführen; Seiten vor dem Export verwalten und anordnen
- Letzte Scans: Schnell auf die zuletzt erstellten Scans zugreifen und sie wiederverwenden
- Inbox-Modus: Standard-Exportordner (über SAF) konfigurieren für reibungsloses Scannen — Dokumente werden automatisch ohne Dateiauswahl gespeichert, ideal für paperless-ngx, Nextcloud oder Syncthing-Workflows
- Teilen & Speichern: Lokal exportieren oder mit anderen Apps teilen
- Dunkelmodus: Material 3-Design mit Tag/Nacht-Unterstützung
- Datenschutzorientiert: 100% Offline-Funktionalität, keine Internetverbindung erforderlich
OCR-Sprachen
MakeACopy unterstützt Offline-OCR mit PaddleOCR. Die Sprache oder Schriftgruppe kann im OCR-Schritt ausgewählt werden.
- Englisch (Englisch)
- Deutsch (Latin)
- Französisch (Latin)
- Italienisch (Latin)
- Spanisch (Latin)
- Portugiesisch (Latin)
- Niederländisch (Latin)
- Polnisch (Latin)
- Tschechisch (Latin)
- Slowakisch (Latin)
- Ungarisch (Latin)
- Rumänisch (Latin)
- Dänisch (Latin)
- Norwegisch (Latin)
- Schwedisch (Latin)
- Türkisch (Latin)
- Chinesisch (Vereinfacht) (Chinesisch)
- Chinesisch (Traditionell) (Chinesisch)
- Russisch (Ostslawisch)
- Thai (Thai)
- Arabisch (Arabisch)
- Persisch/Farsi (Arabisch)
- Hindi (Devanagari)
- Griechisch (Griechisch)
Hinweis: Der durchsuchbare Text eines PDF-Exports liegt als unsichtbare Ebene über dem Seitenbild. Er nutzt eine winzige Schrift ohne sichtbare Zeichen, die in die App eingebaut ist, wie bei Tesseract und OCRmyPDF. So lässt sich Text in jeder Schrift, auch Chinesisch, Japanisch, Arabisch, Persisch und Hindi, durchsuchen und kopieren, ohne dass Schriftdateien mitgeliefert werden müssen.
Editionen und OCR
MakeACopy erkennt Text mit PaddleOCR. Die Full-Edition auf F-Droid, Google Play und GitHub Releases bringt alle Sprachgruppen mit; die Light-Edition auf GitHub Releases nur die lateinische Schrift und ist etwa halb so groß.
Wählen Sie im OCR-Fragment die passende Schrift- oder Sprachgruppe. Für deutsche Dokumente wählen Sie zum Beispiel Latin.
| Dokumentsprache | Auswahl im OCR-Fragment |
|---|---|
| Englisch | Englisch |
| Deutsch, Französisch, Italienisch, Spanisch, Portugiesisch, Niederländisch, Polnisch, Tschechisch, Slowakisch, Ungarisch, Rumänisch, Dänisch, Norwegisch, Schwedisch, Türkisch | Latin |
| Chinesisch vereinfacht oder traditionell | Chinesisch |
| Russisch | Ostslawisch |
| Thai | Thai |
| Arabisch und Persisch/Farsi | Arabisch |
| Hindi | Devanagari |
| Griechisch | Griechisch |
Screenshots
Verwendung
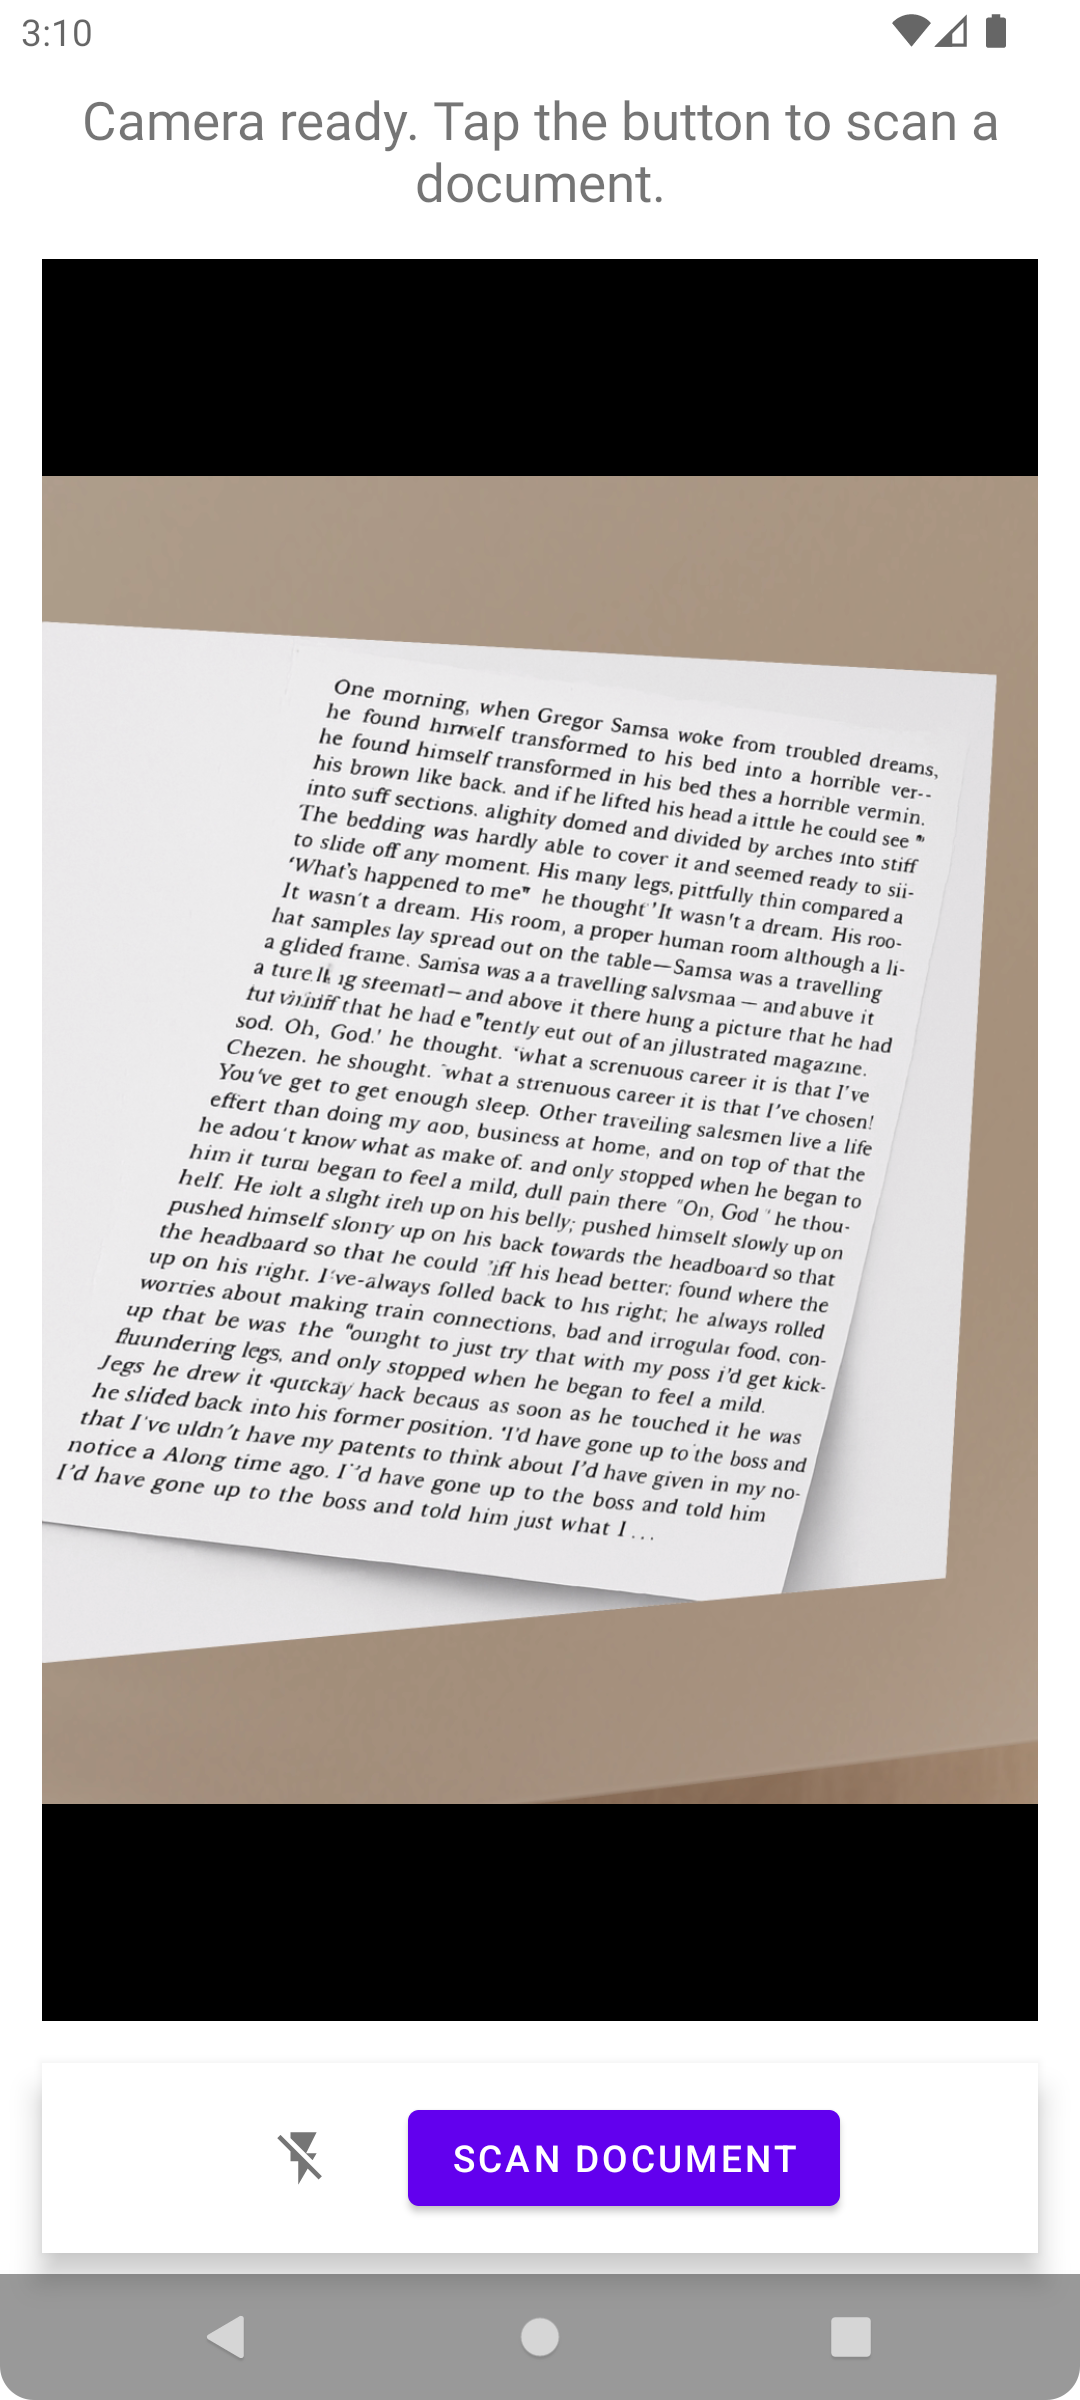
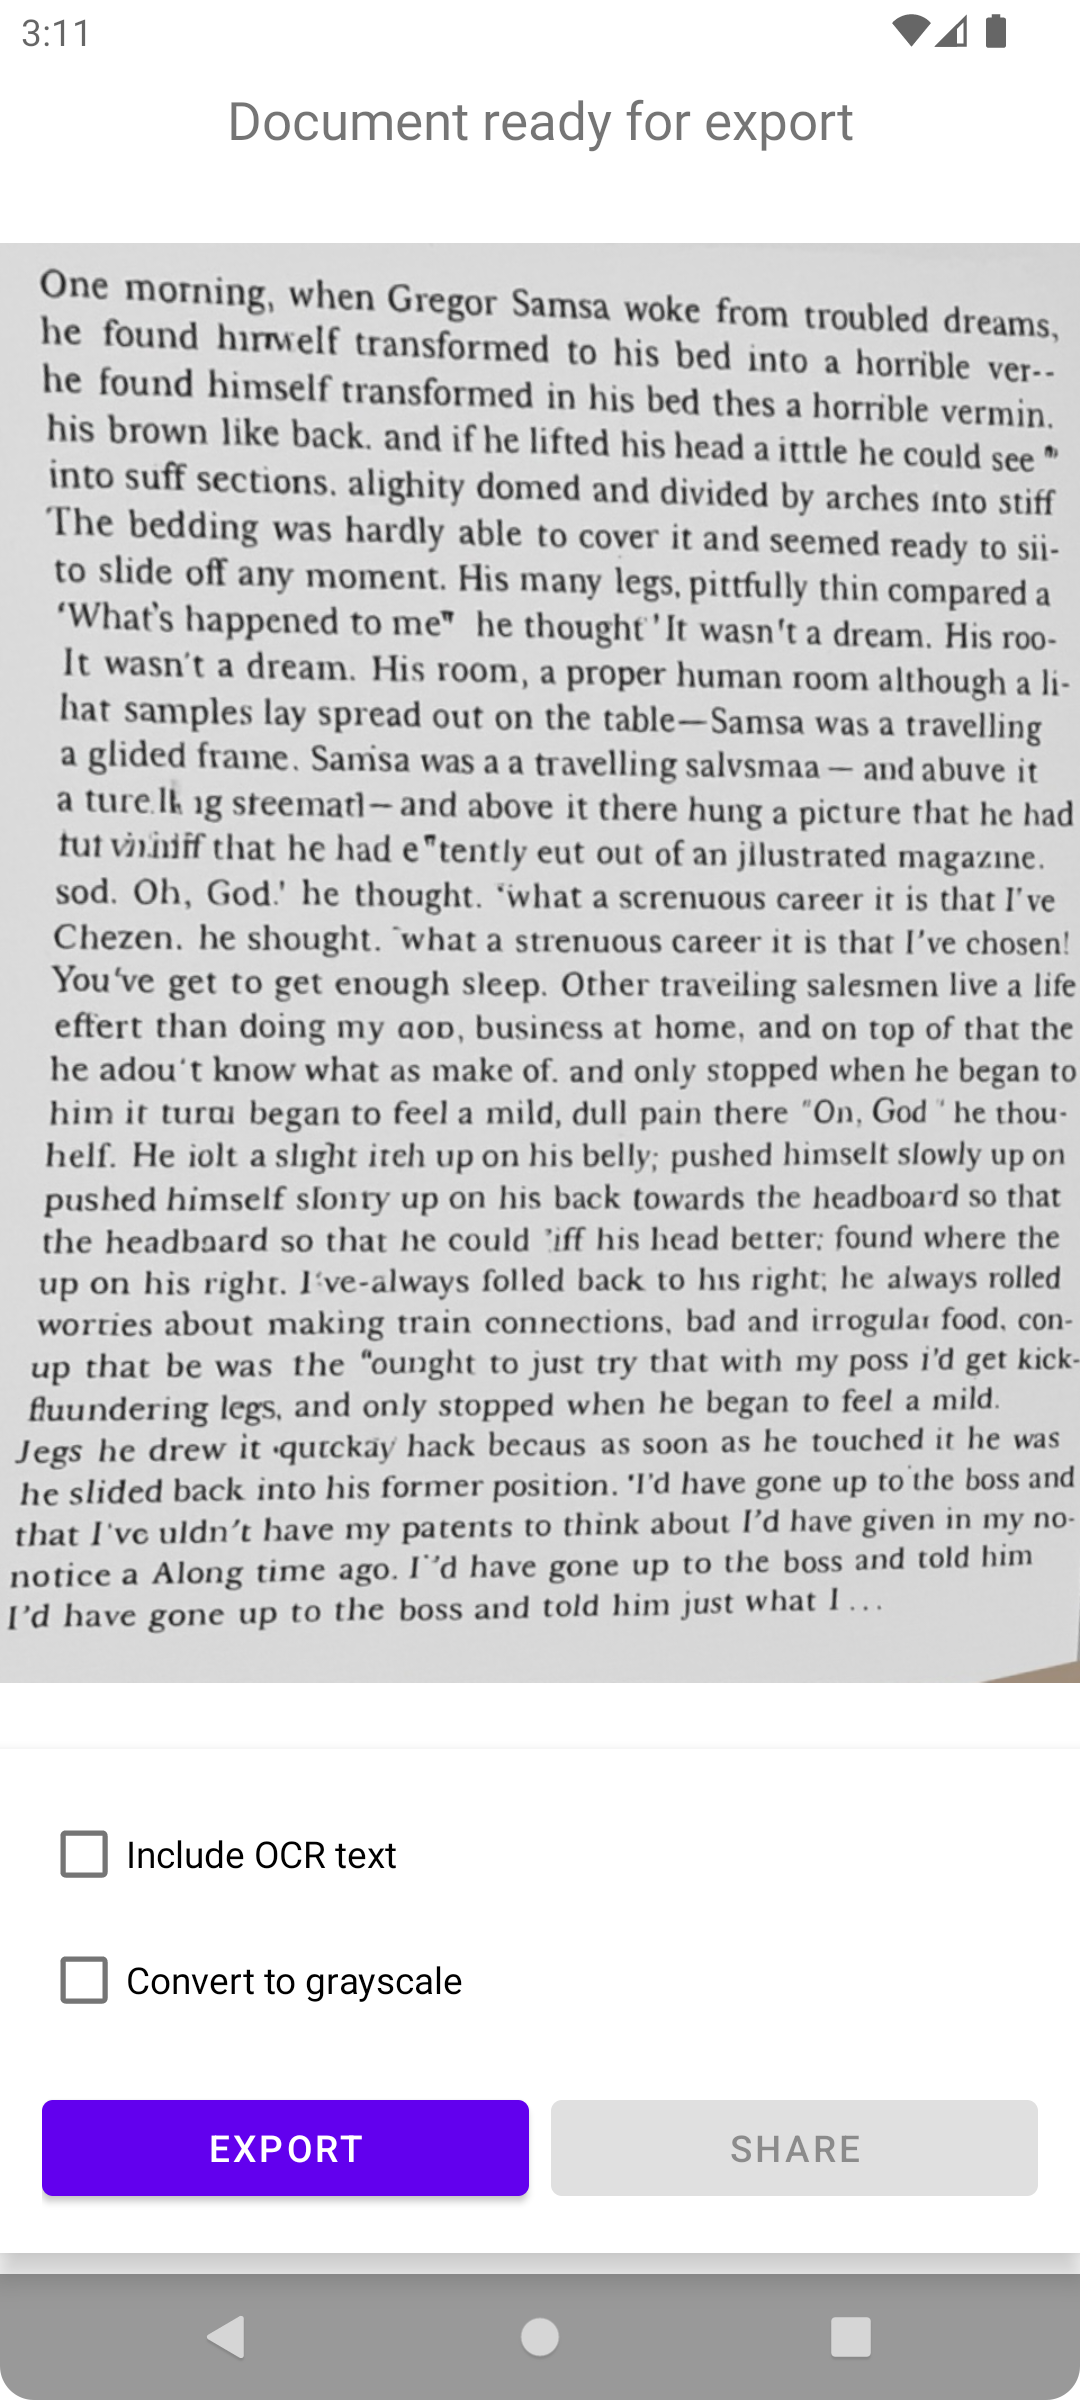
- Dokument scannen: Öffnen Sie die App und tippen Sie auf die Scan-Taste, um ein Dokument zu erfassen
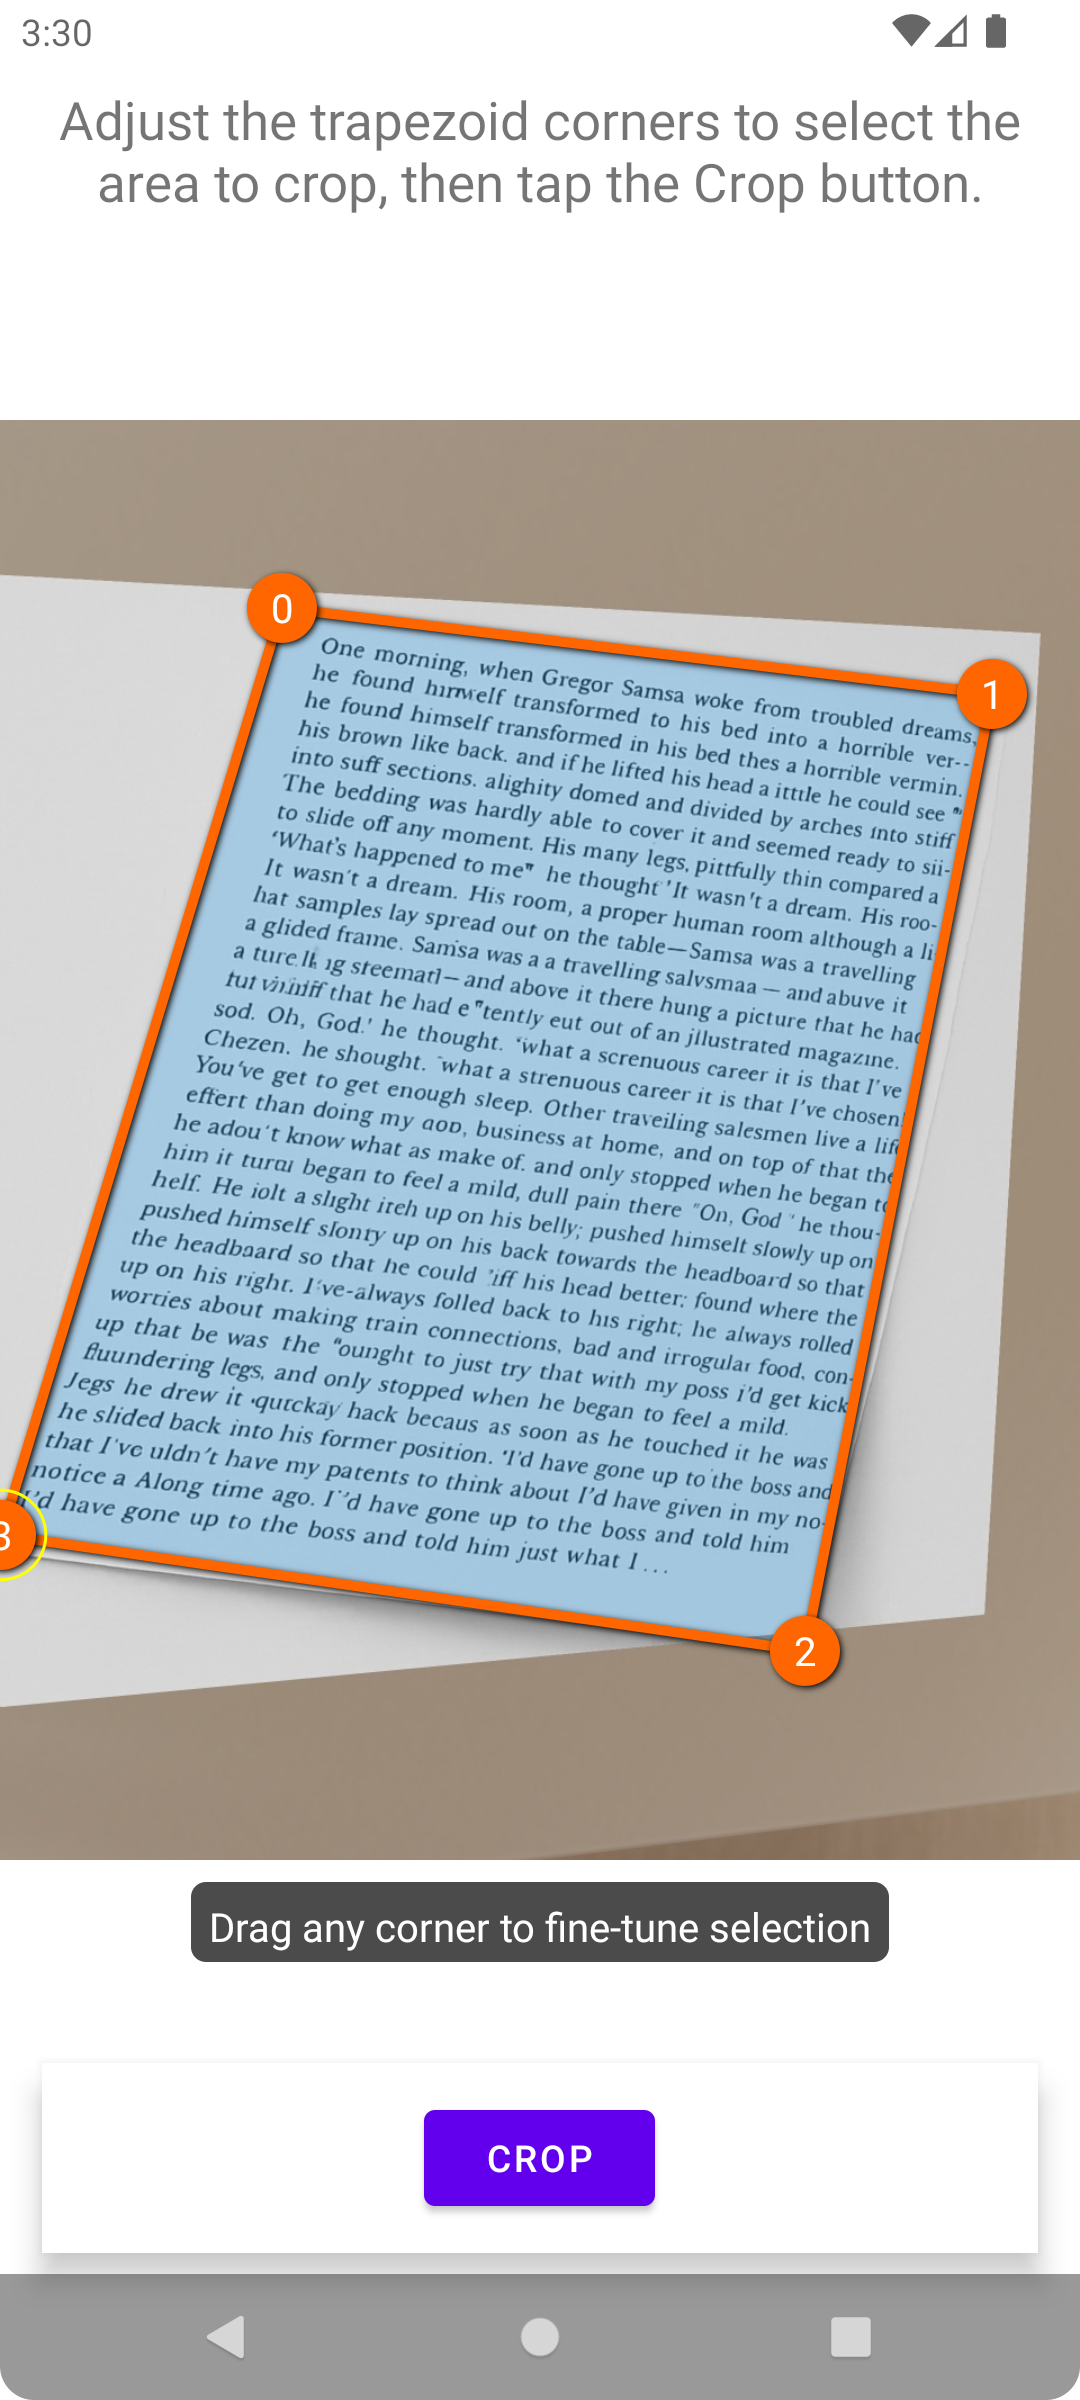
- Ecken anpassen: Feinabstimmung der erkannten Dokumentenränder
- Zuschneiden & Verbessern: Wenden Sie den Zuschnitt an und verbessern Sie das Bild bei Bedarf
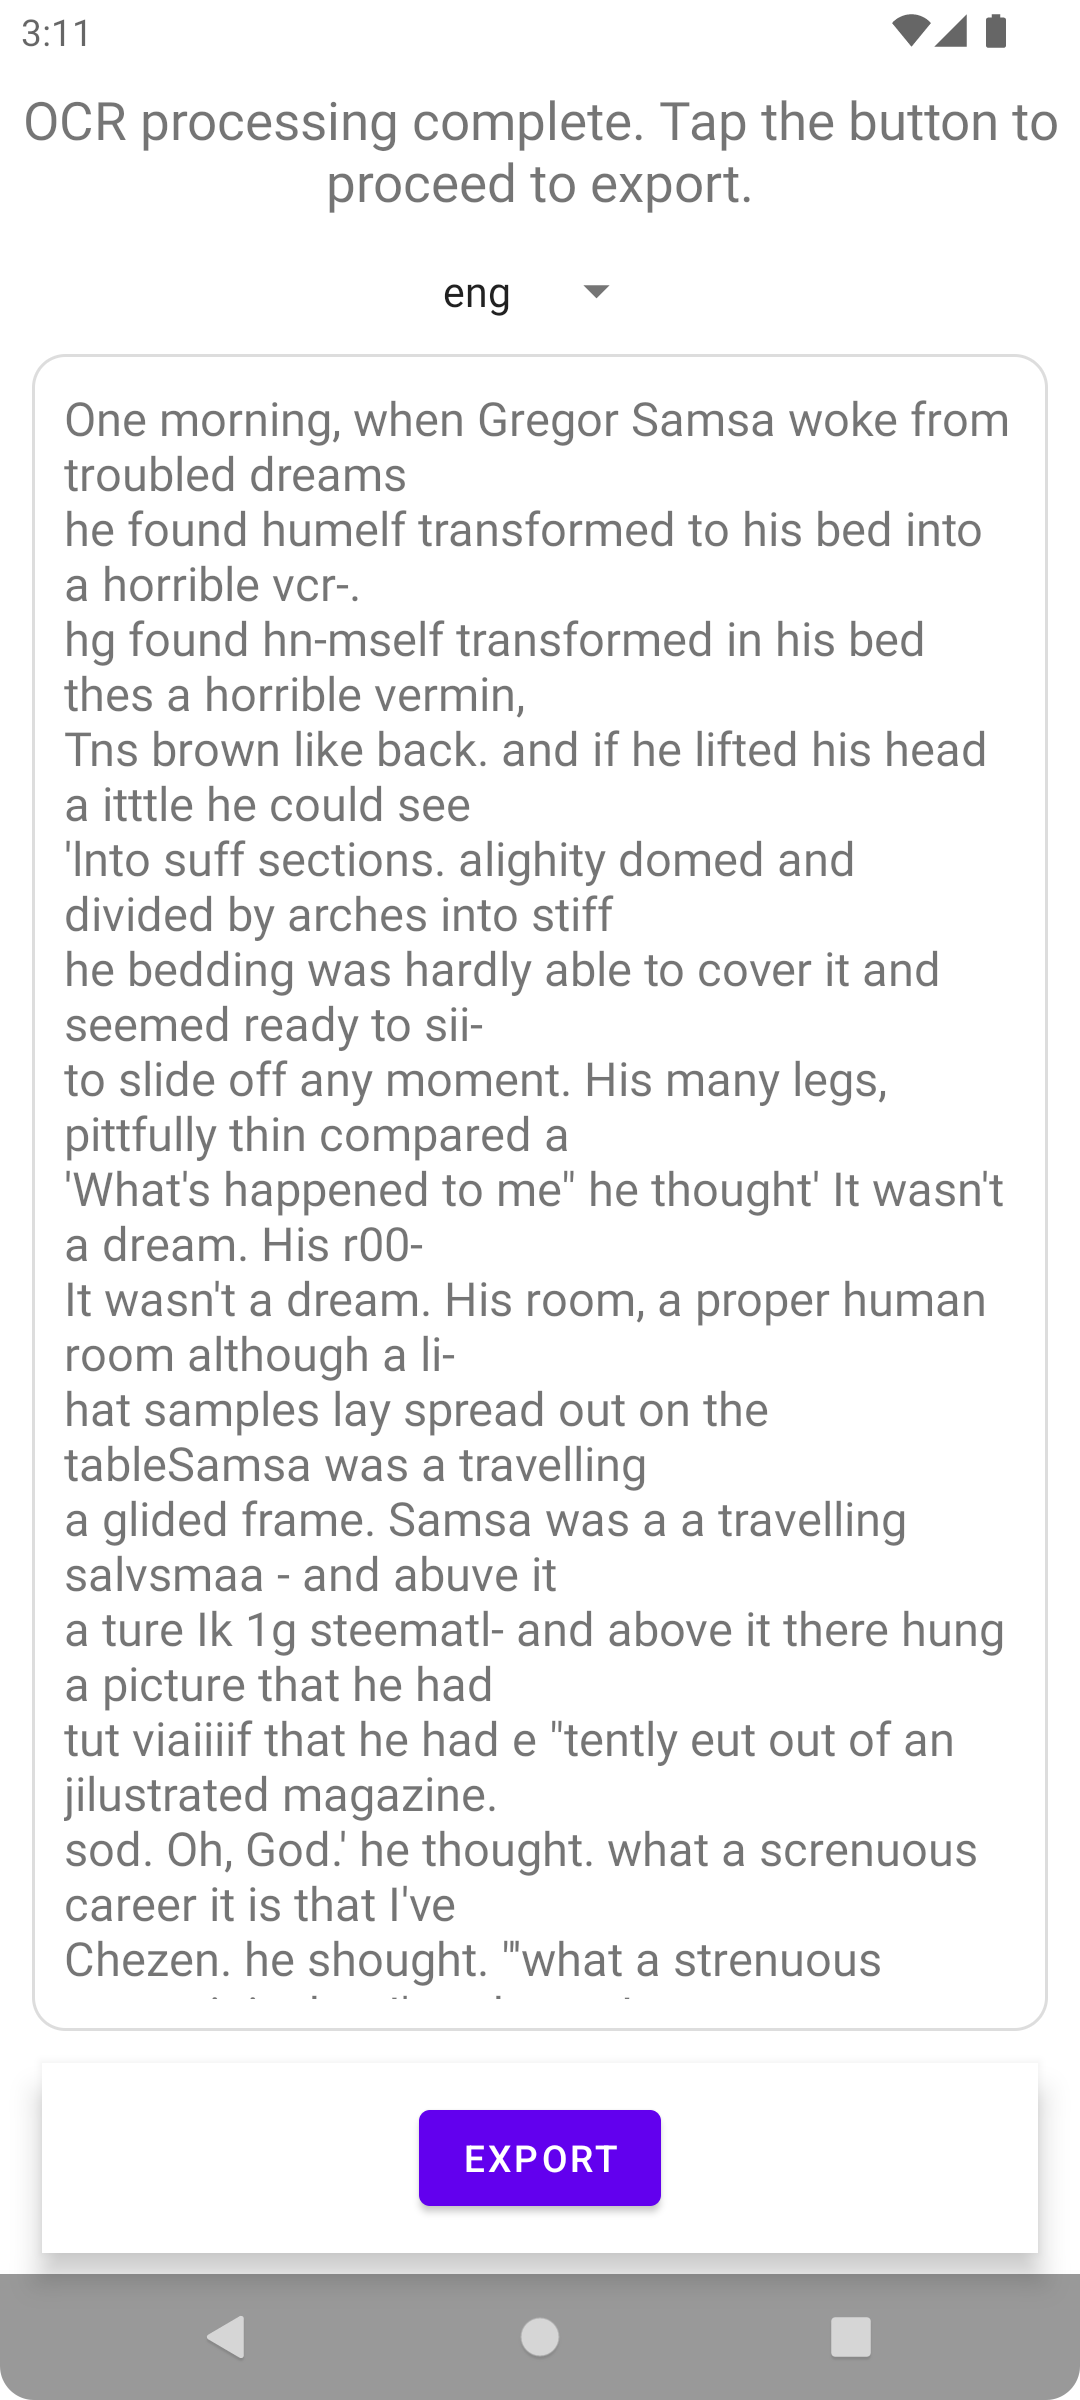
- OCR-Verarbeitung: Die App erkennt Text im Dokument
- Exportieren & Teilen: Als PDF speichern oder mit anderen Apps teilen
Datenschutz
MakeACopy wurde mit Fokus auf Datenschutz entwickelt:
- Keine Internetverbindung erforderlich
- Keine Serveranfragen oder Telemetrie
- OCR-Verarbeitung erfolgt lokal auf Ihrem Gerät
- Erforderliche Berechtigungen: Kamera (und Vibration für haptisches Feedback); keine Speicherberechtigung, Dateien werden über die Systemdialoge ausgewählt
- Keine Verbindungen zu Drittanbietern
Weitere Details finden Sie in unserer Datenschutzerklärung (auf Englisch).
Installation
F-Droid
MakeACopy ist auf F-Droid verfügbar: f-droid.org/packages/de.schliweb.makeacopy.
Für die F-Droid-Konformität wird die einzige native Komponente, ONNX Runtime (CPU Execution Provider, Java-Bindings),
aus dem Quellcode in external/onnxruntime gebaut. Die resultierenden Bibliotheken werden während des Builds in die App integriert; es werden keine vorcompilierten
Binärdateien im Repository gespeichert.
GitHub Releases
Sie können die neueste APK von der Releases-Seite herunterladen.
APK-Überprüfung
Um die Echtheit der MakeACopy-Releases zu prüfen, vergleiche den unten angegebenen Fingerabdruck des Signaturzertifikats
mit der Ausgabe von apksigner oder AppVerifier.
SHA-256
- Upload-Schlüssel (GitHub / F-Droid / Sideload-APKs)
AE:32:2D:3F:B7:1A:FE:21:DF:47:27:E3:7A:5C:68:03:51:1D:5A:2F:E1:FC:31:35:43:0C:EE:06:99:FA:1B:34 - Google Play App-Signaturschlüssel (Play-Store-Versionen)
C0:71:44:39:CB:51:62:32:A4:47:91:7A:6F:C2:28:1E:45:FA:AA:DD:37:F8:30:B1:01:1F:B4:85:68:8E:0D:64
Verifikationsbefehle
# Mit apksigner (aus den Android SDK build-tools)
apksigner verify --print-certs MakeACopy-vX.Y.Z.apk

# Mit AppVerifier (https://github.com/soupslurpr/AppVerifier)
appverifier verify MakeACopy-vX.Y.Z.apk
❤️ Unterstütze dieses Projekt
MakeACopy ist frei und quelloffen. Wenn dir die App hilft, erwäge bitte eine kleine Unterstützung:

FAQ
Scannen (Kamera)
- Das Bild ist unscharf / Text schwer lesbar
- Achte auf genügend Licht; vermeide schwaches, warmes Umgebungslicht.
- Halte das Gerät ruhig oder stütze es ab.
- Aktiviere den Autofokus durch Antippen des relevanten Bereichs im Sucher (falls verfügbar).
- Erhöhe den Abstand leicht und schneide später zu – zu nah kann den Fokus erschweren. - Starke Schatten oder Reflexionen
- Beleuchte das Dokument gleichmäßig von mehreren Seiten.
- Vermeide direkte Lichtquellen, die Spiegelungen erzeugen (z. B. über glänzendem Papier).
- Lege das Dokument auf einen matten, kontrastreichen Untergrund. - Das Bild ist zu dunkel/hell
- Verbessere die Beleuchtung.
- Schalte den Blitz nur bei Bedarf ein – er kann Reflexe verursachen. - Verzerrte Perspektive
- Fotografiere möglichst frontal und parallel zur Dokumentenfläche. - Was bedeutet der Framing-/Qualitäts‑Score?
Der Accessibility‑Modus kann beim Ausrichten einen Prozentwert (0–100 %) ansagen. Dieser Wert ist ein „Confidence“-Indikator der aktuellen Eckenerkennung: Er basiert auf (a) dem Flächenanteil des erkannten Vierecks im Bild, (b) wie rechteckig die Ecken sind (Winkel näher an 90°), und (c) wie symmetrisch gegenüberliegende Kantenlängen sind.
Wichtig: Die Stabilität über mehrere Frames wird separat genutzt, um Ansagen ruhiger zu machen – sie ist nicht Teil dieses Prozentwerts. - Wie kann ich den Score verbessern?
- Gleichmäßiges, helles Licht; Blendungen und harte Schatten vermeiden.
- Telefon parallel zur Seite halten; nicht kippen. Kleinen Rand lassen, alle vier Ecken sichtbar.
- Wenn du zu nah dran bist, etwas zurückgehen und später zuschneiden.
- Papier auf matten, kontrastreichen Untergrund legen.
- Kurz stillhalten, damit sich die Erkennung stabilisieren kann.
- Orientierung passend wählen: A4/Letter → meist Hochformat; sehr breite Belege/Karten → Querformat. - Soll ich beim Aufnehmen im Hoch- oder Querformat halten?
A4/Letter: Hochformat passt meist am besten. Sehr breite Vorlagen (Belege, Karten): Querformat probieren. Die Hinweise passen sich deiner Haltung an. - Was bedeuten „links/rechts/oben/unten“ im Querformat?
Hinweis zur Gerätehaltung (Querformat): Die Kameraansicht der App bleibt im Hochformat (Portrait). Die Richtungs‑Hinweise („links/rechts/oben/unten“) beziehen sich auf die aufrecht ausgerichtete Vorschau.
Wenn du das Telefon seitlich hältst, kann es je nach Gerät/Android‑Version sein, - dass die Hinweise weiterhin wie im Hochformat gemeint sind (weil die Oberfläche nicht ins Querformat wechselt), oder - dass die Analyse‑Achsen intern mit der Display‑Ausrichtung mitgehen.
Wenn dir „links/rechts/oben/unten“ unlogisch vorkommt, richte das Telefon wieder ins Hochformat aus oder drehe es um 180° und prüfe, ob die Hinweise dann besser passen. - Ich höre ständig „Weiter weg/Move back“
Die App unterdrückt Distanz‑Hinweise ohne erkennbares Dokument und drosselt Wiederholungen. Beleuchtung verbessern (Taschenlampe bei Bedarf), ganze Seite mit kleinem Rand ins Bild nehmen, kurz ruhig halten. - Gibt es einen Tipp für Hoch‑/Querformat?
Ja. Im Accessibility‑Modus kann die App einen Hinweis geben, ob Hoch‑ oder Querformat für die aktuelle Seite sinnvoller wirkt.
Der Hinweis wird nur gegeben, wenn - die Schätzung ausreichend sicher ist (Konfidenz ≥ 0,30) und - aktuell kein plausibles Dokument erkannt wird (damit die normalen Ausrichtungs‑Hinweise nicht überlagert werden).
Damit es ruhig bleibt, wird der Hinweis über dieselbe Guidance‑Logik wie die anderen Ansagen geglättet (kurze Stabilität über mehrere Frames) und zeitlich begrenzt (Rate‑Limit).
Eckenerkennung (Randerkennung)
- Dokumentränder werden falsch erkannt
- Sorge für guten Kontrast zwischen Dokument und Untergrund (z. B. helles Papier auf dunklem Tisch).
- Glätte das Papier (keine Wellen/Knicke) und richte es gerade aus.
- Vermeide Schatten, die wie Ränder interpretiert werden können. - Keine automatische Erkennung
- Mit eingeschalteter Vorschau Eckenerkennung zeigt die Kamera keinen Umriss, solange sich das Modell der Seite nicht sicher ist, etwa im Dunkeln oder bei abgedeckter Linse.
- Wiederhole die Aufnahme mit besserer Beleuchtung.
- Nutze die manuelle Eckenkorrektur nach dem Scan, um Punkte zu verschieben. - Ergebnis ist schief oder abgeschnitten
- Prüfe nach der automatischen Erkennung alle vier Punkte und korrigiere sie bei Bedarf manuell.
OCR (Texterkennung)
- OCR erkennt kaum Text
- Stelle sicher, dass die richtige Sprache ausgewählt ist.
- Scanne in guter Qualität: scharf, ausreichend Licht, kein Rauschen.
- Vermeide sehr kleine Schrift – fülle die Seite mehr aus oder scanne näher (ohne Unschärfe). - Falsche Sprache / Akzente werden nicht erkannt
- Wähle die passende OCR-Sprache in der App. - Gemischte Sprachen im Dokument
- Wenn möglich, scanne Abschnitte getrennt pro Sprache.
- Alternativ die primäre Sprache wählen; Mischtexte können die Erkennungsrate reduzieren. - Handschrift wird nicht erkannt
- Tesseract ist primär für Druckschrift ausgelegt; handschriftliche Texte werden nur eingeschränkt erkannt.
- Bessere Ergebnisse mit klarer, druckähnlicher Schrift; ansonsten manuelle Erfassung erwägen. - OCR-Drehung/Orientierung falsch
- Die App erkennt die Ausrichtung automatisch: Sie testet die OCR intern in 90°‑Schritten (0°, 90°, 180°, 270°) und verwendet das beste Ergebnis. Bei bereits korrekt ausgerichteten Seiten wird aus Zeitgründen früh abgebrochen.
- Falls die Seite stark schief ist, drehe sie vor der OCR mit den Dreh‑Tasten in 90°‑Schritten, bis die Textzeilen horizontal verlaufen.
- Vermeide starke Perspektive; richte das Dokument möglichst gerade aus. - Was macht die Option „OCR‑Auto‑Drehung (auch beim Export anwenden)“?
Wenn diese Option aktiv ist, versucht die App die OCR zusätzlich in 90°‑Schritten (0°, 90°, 180°, 270°) und wählt das beste Ergebnis (nach OCR‑Konfidenz; bei Gleichstand nach Textlänge). Wenn die erste Prüfung (0°) bereits „gut genug“ ist, werden die weiteren Drehungen übersprungen, um Zeit zu sparen.
Zusätzlich wird die gefundene Drehung auf den aktuellen Scan übernommen, sodass das Bild beim Export entsprechend gedreht wird. Wenn die Option aus ist, wird OCR nur in der aktuellen Ausrichtung ausgeführt und es wird nichts automatisch für den Export gedreht. - Suche im PDF funktioniert nicht
- Prüfe, ob die gewählte Sprache korrekt war; falsche Sprache erzeugt unpassenden erkannten Text.
- Alternativ kannst du den OCR-Text auch separat als TXT exportieren.
OCR Review
- Was ist OCR Review?
OCR Review ist ein interaktiver Bildschirm, auf dem du den erkannten Text vor dem Export überprüfen und korrigieren kannst. Jedes erkannte Wort wird als Box über dem Dokument angezeigt, mit farbcodierter Konfidenz-Hervorhebung (grün = hohe Konfidenz, rot = niedrige Konfidenz). - Wie öffne ich OCR Review?
Nach Abschluss der OCR-Verarbeitung tippe auf die Schaltfläche „Review" (Stift-Symbol) im OCR-Bildschirm. Dies öffnet den Review-Bildschirm, in dem du die Ergebnisse prüfen und bearbeiten kannst. - Welche Ansichtsmodi gibt es?
Der Review-Bildschirm hat drei Tabs:
- Layout: Zeigt Wort-Boxen auf neutralem Hintergrund. Tippe auf ein Wort zum Bearbeiten, halte gedrückt für weitere Optionen.
- Document: Zeigt das Original-Scan-Bild mit darüberliegenden Wort-Boxen. Nützlich zum Vergleichen der OCR-Ergebnisse mit dem tatsächlichen Dokument.
- Text: Eine reine Texteditor-Ansicht, in der du den gesamten Text direkt bearbeiten kannst. - Was ist der Unterschied zwischen Tippen und langem Drücken auf ein Wort?
Tippen (kurzer Klick): Öffnet den Inline-Bearbeitungsdialog, in dem du:
- Den Worttext direkt bearbeiten kannst
- Wörterbuch-basierte Vorschläge siehst (falls verfügbar) und auf einen Vorschlag tippen kannst, um ihn anzuwenden
Langes Drücken (gedrückt halten): Öffnet ein Kontextmenü mit zusätzlichen Optionen:
- Bearbeiten…: Wie Tippen — öffnet den Inline-Bearbeitungsdialog
- Mit nächstem zusammenführen: Kombiniert dieses Wort mit dem folgenden Wort zu einem
- Teilen: Teilt das Wort in der Mitte in zwei separate Wörter
- Löschen: Entfernt das Wort vollständig
- Groß-/Kleinschreibung: Ändert die Schreibweise (GROSSBUCHSTABEN, kleinbuchstaben, Titel-Schreibweise)
- Sprache…: Legt die Sprache für dieses spezifische Wort fest und führt optional die OCR nur für dieses Wort erneut aus - Was sind die Wörterbuch-Vorschläge?
Wenn du auf ein Wort tippst, um es zu bearbeiten, zeigt die App Vorschläge aus dem Wörterbuch basierend auf der Ähnlichkeit zum aktuellen Wort. Dies hilft, häufige OCR-Fehler zu korrigieren. Tippe auf einen Vorschlags-Chip, um ihn anzuwenden. Vorschläge werden nach Levenshtein-Ähnlichkeit sortiert, mit spezieller Gewichtung für typische OCR-Verwechslungen (0↔O, 1↔l, 5↔S usw.). - Was macht „Re-OCR"?
Im Sprach-Dialog (langes Drücken → Sprache…) kannst du eine andere Sprache auswählen und auf „Re-OCR" tippen. Dies führt die Texterkennung nur für dieses einzelne Wort mit der ausgewählten Sprache erneut aus. Nützlich, wenn ein Wort in einer anderen Schrift (z. B. Persisch in einem englischen Dokument) falsch erkannt wurde. - Wie speichere ich meine Änderungen?
Tippe auf die Schaltfläche „Speichern" am unteren Rand des Review-Bildschirms. Dies übernimmt deine Korrekturen in das OCR-Ergebnis. Wenn du auf „Zurück" oder die X-Schaltfläche tippst und ungespeicherte Änderungen vorliegen, wirst du gefragt, ob du sie verwerfen möchtest. - Was bedeuten die farbcodierten Boxen?
- Grüner/türkiser Rand: Hohe Konfidenz — die OCR-Engine ist ziemlich sicher bei diesem Wort
- Roter Rand: Niedrige Konfidenz (unter 60 %) — das Wort sollte manuell überprüft werden
- Gelber Rand: Aktuell ausgewähltes Wort
Weitere Fragen? Bitte ein Issue eröffnen: github.com/egdels/makeacopy/issues.
Lizenz
MakeACopy ist unter der Apache License 2.0 lizenziert.
Copyright 2025 Christian Kierdorf

Licensed under the Apache License, Version 2.0 (the "License");
you may not use this file except in compliance with the License.
You may obtain a copy of the License at

    http://www.apache.org/licenses/LICENSE-2.0

Unless required by applicable law or agreed to in writing, software
distributed under the License is distributed on an "AS IS" BASIS,
WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
See the License for the specific language governing permissions and
limitations under the License.